Ein Positionspapier für Hochschulen
Doris Weßels, Andrea Klein, Margret Mundorf, Kirsten Schindler & Nicolaus Wilder
20. August 2026
Die trügerische Hoffnung auf technische Gewissheit
Je stärker generative KI in sämtliche Gesellschaftsbereiche wie Bildung, Forschung und Arbeitswelt eingedrungen ist, desto größer ist offenbar die Überforderung beim Umgang mit dem neuen “Akteur”. Sie findet ihren Ausdruck in dem Wunsch nach mehr Transparenz und einer vermeintlich einfachen Lösung, um unmittelbar und technisch valide erkennen zu können, ob ein Text von einer KI stammt. KI-Detektoren und KI-Markierungen wie ein Wasserzeichen treffen auf diesen Bedarf und bieten eine Scheinlösung für ein Problem, das möglicherweise ganz anderer Lösungen bedarf.
Das Schreiben von Texten verstehen wir inzwischen als synergetische Interaktion zwischen Mensch und Maschine, bei der generative KI-Systeme nicht nur als Werkzeuge bedient werden, sondern auch als digitale Schreibpartner agieren. Wenn dies so ist, dann lassen sich bei dieser Symbiose mit Blick auf das Endergebnis einzelne Textstellen weder eindeutig dem Menschen noch einem KI-System zuordnen.
Die entscheidende Frage lautet daher nicht, ob bei der Textproduktion KI-Systeme beteiligt waren, sondern wie souverän, an fachlichen und wissenschaftlichen Standards bzw. Gütekriterien orientiert und KI-kompetent hat der Mensch in der Interaktion agiert? Wie wurde KI eingesetzt? Wurden Ergebnisse geprüft und, wenn ja, in welcher Form? Inwieweit zeigen die Lernenden (wissenschaftlich Arbeitenden, Forschenden) Verantwortungsbewusstsein in der Ko-Aktivität mit KI-Systemen? Gerade bei solchen Fragen versagen KI-Detektoren und KI-Markierungstechniken wie z. B. unsichtbare Wasserzeichen und bieten keine Lösung.
Der rechtliche Rahmen: Die KI-Verordnung (KI-VO)
Die KI-Kennzeichnung nach der KI-Verordnung der EU (abgekürzt: KI-VO, engl. AI Act) verfolgt vor allem ein Transparenz- und Vertrauensschutzziel, damit Menschen erkennen können, ob sie mit KI interagieren beziehungsweise ob Inhalte künstlich erzeugt oder manipuliert wurden. Nach Art. 50 Abs. 2 KI-VO sind Anbieter generativer KI-Systeme verpflichtet, synthetische Text-, Bild-, Audio- und Videoausgaben maschinenlesbar zu markieren und als künstlich erzeugt oder verändert erkennbar zu machen. Die technischen Lösungen sollen – soweit technisch möglich – wirksam, interoperabel, belastbar und zuverlässig sein. Auf diese Qualitätsanforderungen ist das Augenmerk zu richten.
Seit dem 2. August 2026 gilt der Verhaltenskodex für die Transparenz von KI-generierten Inhalten (European Commission 2026) für KI-Modelle, die nach dem Stichtag veröffentlicht wurden.
Technischer Hintergrund: Das Wasserzeichen und die Limitationen
Kirchenbauer et al. haben bereits 2023 ein Wasserzeichen-Framework für proprietäre Sprachmodelle vorgestellt, so dass das Wasserzeichen in einen Text integriert werden kann „with negligible impact on text quality”. Ergänzend dazu haben sie für die KI-Detektion einen Open-Source-Algorithmus entwickelt, ohne dass ein Zugriff auf die Schnittstelle oder die Parameter des Sprachmodells erforderlich ist (Kirchenbauer et al. 2023).
Am 07.05.2024 hat OpenAI (mit Update vom 04.08.2024) seine aktuellen Forschungsansätze zu Text-Wasserzeichen erläutert und explizit auf die Limitationen hingewiesen: „it is less robust against globalized tampering; like using translation systems, rewording with another generative model, or asking the model to insert a special character in between every word and then deleting that character” (OpenAI 2024).
OpenAI hat zusätzlich darauf hingewiesen – für den Einsatz im Bildungsbereich besonders relevant –, dass bestimmte Gruppen, wie z. B. Nicht-Muttersprachler:innen, unverhältnismäßig häufig verdächtigt oder bei der Nutzung von KI-Schreibhilfen stigmatisiert werden könnten. Zwar weise das Text-Wasserzeichen laut OpenAI eine niedrige Falsch-Positiv-Rate auf, doch würde seine Anwendung auf große Textmengen zu einer hohen Gesamtzahl an Falsch-Positiven führen. Aus dem Grund wurde angekündigt, andere Ansätze wie Metadaten zur kryptografischen Signatur weiter erforschen zu wollen.
Wenige Tage später hat Google DeepMind am 14.05.2024 seine Wasserzeichen-Markierung SynthID vorgestellt (Dathathri et al. 2024; Google DeepMind 2024). Es steht als Open-Source-Lösung auf GitHub (https://github.com/google-deepmind/synthid-text) zur Verfügung.
Der Mechanismus von SynthID zur Generierung des Wasserzeichens für Texte und zur Erkennung eines KI-generierten Textes folgt einem einfachen Schema:
- Große Sprachmodelle erzeugen Texte, indem sie Schritt für Schritt den wahrscheinlich nächsten Textbaustein („Token“) auswählen, z. B. ein Zeichen, ein Wort oder eine Wortsilbe.
- SynthID verändert dabei unmerklich die Wahrscheinlichkeiten bestimmter Tokens, sodass im fertigen Text ein charakteristisches Muster entsteht, ohne dessen sprachliche Qualität zu beeinträchtigen.
- Ein Detektor untersucht die verwendeten Tokens und vergleicht ihr Muster mit den statistisch erwarteten Mustern von Texten mit und ohne Wasserzeichen, um zu bestimmen, ob der Text wahrscheinlich von einer KI stammt (Google DeepMind 2024).
Anthropic hat erst in diesem Monat am 10.08.2026 (Anthropic 2026b) seinen Ansatz zur Wasserzeichen-Markierung vorgestellt, der eine Variante des SynthID-Algorithmus von Google ist. Auch hier entscheidet das Modell über die Auswahl der Token nicht nach Wahrscheinlichkeit und semantischer Präzision, allerdings hier nach einem bisher nicht im Detail veröffentlichten Algorithmus. Die Hinweise zu den Limitationen der Wasserzeichen-Kennzeichnung gleichen denen der Wettbewerber:
- Eine erkannte Markierung bedeutet nicht, dass Claude der ursprüngliche Autor war. Das System könnte einen Text lediglich korrigiert, übersetzt, zusammengefasst oder konvertiert haben. Damit sind aber sehr unterschiedliche Modi und Grade von Eingriffen in die Textproduktion betroffen.
- Umgekehrt bedeutet das Fehlen einer erkannten Kennzeichnung nicht, dass zu keinem Zeitpunkt eine KI beteiligt war. Starke Bearbeitung, Umformulierung, Übersetzung, Vermischung mit anderem Text, kurze Passagen oder entfernte Metadaten können die Erkennbarkeit beeinträchtigen. Auch in Textpassagen, die Faktenwissen referieren, bei denen es also weniger Möglichkeiten von Token-Kombinationen gibt, die Textgenauigkeit sicherstellen, ist die Anwendung von Wasserzeichen weniger wirksam. Ähnliches gilt für die bloße Korrektur von Grammatik und Rechtschreibung von Texten, da auch hier kaum Wahlmöglichkeiten bestehen.
- Sehr lesenswert sind die aktuellen „Announcements“ von Anthropic vom 14.08.2026 zu den vielfältigen Fragen, die in diesem FAQ-ähnlichen Beitrag sehr anschaulich erläutert werden (Anthropic 2026a).
Die folgende Abbildung 1 zeigt die Funktionsweise von Paraphrasierungstools wie declaude (entwickelt von James und Alice Padolsey), mit denen sprachliche Muster leicht verändert werden können.
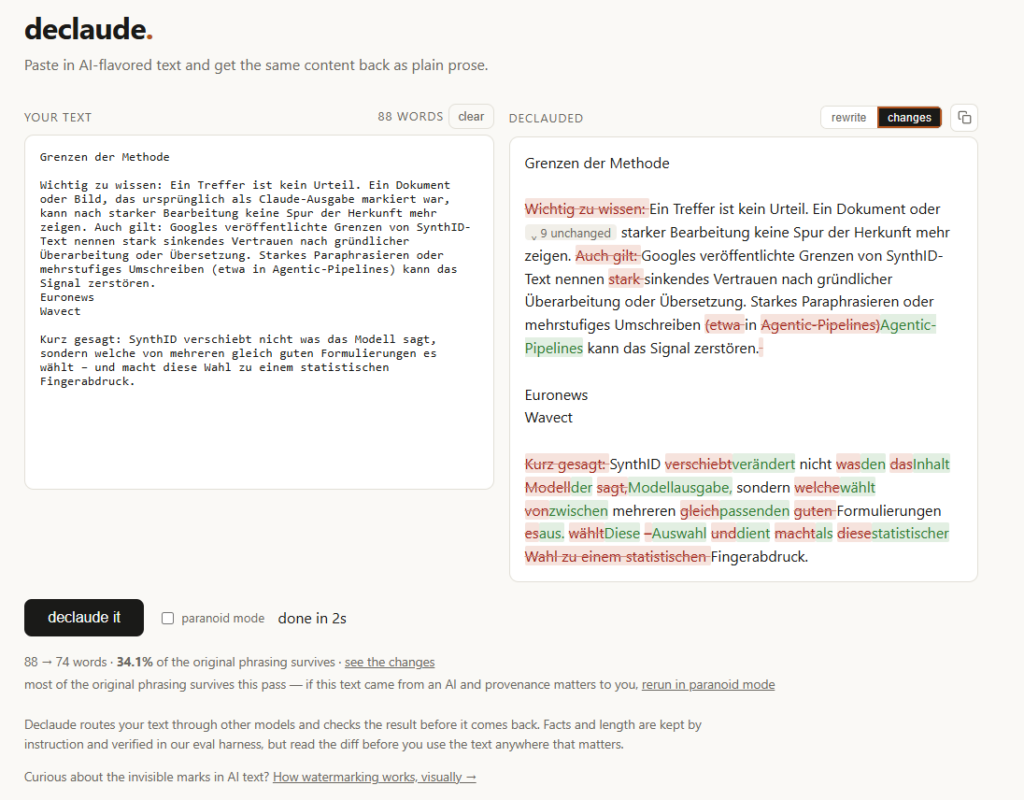
Die belastbare Schlussfolgerung lautet daher nicht, dass Anbieter nicht an ihre Verfahren glauben. Sie lautet: Die Anbieter selbst begrenzen ausdrücklich, welche Schlussfolgerungen aus ihren technischen Markierungen gezogen werden dürfen und welche auch aus ethischen Überlegungen problematisch sind.
Das Wasserzeichen: Der einfache Weg der KI-Kennzeichnung
Die KI-VO schreibt kein Wasserzeichen als zwingende technische Lösung vor. Erwägungsgrund 133 (Europäische Union 2024) nennt neben Wasserzeichen auch andere Techniken wie Metadatenidentifizierungen, kryptografische Herkunfts- und Authentizitätsnachweise, Protokollierung und Fingerabdrücke. Die bisherige Entwicklung spiegelt aber sehr deutlich wider, dass der Einsatz von Wasserzeichen zur KI-Kennzeichnung für die KI-Anbieter als einfachster Weg der Umsetzung erscheint.
Zu erwähnen ist in diesem Zusammenhang noch der freiwillige Verhaltenskodex (Code of Practice), den rund 190 Unternehmen (darunter Google, OpenAI und Anthropic, nicht jedoch xAI von Elon Musk) bis Ende Juli unterzeichnet haben, um nachzuweisen, dass sie die gesetzlichen Pflichten erfüllen (Europäische Kommission 2026). Die Kodexmaßnahmen gelten als EU-weit anerkannter Rahmen, so dass Anbieter nicht gegenüber jedem einzelnen Land und den entsprechenden Marktüberwachungsbehörden ihr gewähltes Verfahren der KI-Kennzeichnung nachweisen müssen.
Für KI-Systeme, die bereits vorher auf dem Markt waren, sieht die konsolidierte Fassung der KI-VO für die Markierungs- und Erkennungspflicht eine Übergangsfrist bis zum 2. Dezember 2026 vor. Das erklärt, warum die Markierung derzeit nicht bei allen Modellen und Ausgaben einheitlich verfügbar ist.
Zur Konkretisierung: Die Gefahr der Schieflage
Betrachten wir zwei unterschiedliche Fälle am Beispiel des Einsatzes der KI-Lösung Claude des Anbieters Anthropic, die jeweils bestimmte Schreibpraktiken betreffen:
- Studentin A entwickelt eigenständig ihre Forschungsfrage, die Argumentation und den Text und lässt ihren fertigen Entwurf erst am Ende von Claude sprachlich korrigieren und glätten. Ihr Text wird mit hoher Wahrscheinlichkeit eine Claude-Wasserzeichen-Markierung tragen.
- Student B lässt sich zunächst einen umfangreichen Entwurf von Claude generieren und steigt erst danach in die eigene Textarbeit ein und überarbeitet, korrigiert und ergänzt den KI-Entwurf mit eigenem Material. Gerade diese Bearbeitungsschritte können das Wasserzeichen zerstören. Darauf weisen alle zuvor genannten Anbieter von Wasserzeichen-Markierungen in Texten hin.
Das paradoxe Ergebnis:
Der Text mit der aus unserer Sicht höheren menschlichen Eigenleistung im Falle von Studentin A kann technisch, aber möglicherweise auch sprachlich auffälliger sein als der Text mit dem größeren KI-Anteil im Falle von Student B.
Daraus lassen sich für uns nun folgende Schlussfolgerungen ziehen:
- Ein positives Signal beweist keine exklusive KI-“Autorschaft”.
- Ein negatives Signal beweist wiederum keine ausschließlich menschliche Autorschaft.
- Ist ein KI-Einsatz vorab untersagt worden, dann können vorhandene Wasserzeichen keine belastbare Grundlage für einen Täuschungsvorwurf bieten. Der obige Fall von Student B zeigt, dass eine typische (und möglicherweise nicht einmal besonders gravierende) Überarbeitung ausreicht, um ein Detektionssignal erheblich zu verändern. Daher darf dieses Signal nicht zur vermeintlich objektiven Grundlage für Bewertungen oder auch Sanktionen herangezogen werden.
Nicht Detektion, sondern zeitgemäße Lehre und Prüfungen
Wasserzeichen suggerieren eine verlässliche technische Kennzeichnung und Erkennbarkeit, sofern der Detektor öffentlich verfügbar ist. Wie bereits zuvor erwähnt, hat Anthropic für sein KI-System Claude diesen Detektor bislang lediglich angekündigt, aber noch nicht veröffentlicht.
Daraus lässt sich nun aber nicht der Schluss ziehen, dass damit ein belastbares oder zuverlässiges Konstrukt zur Bewertung der menschlichen Leistung bei der KI-gestützten Textgenerierung zur Verfügung steht. Denn wesentliche Qualitätsanforderungen werden nicht erfüllt, was auch die Frage der Konsequenzen für die Anbieter von Wasserzeichen aufwirft, die offensichtlich kein wirksames und belastbares KI-Erkennungszeichen darstellen. Genau hier wird das Wasserzeichen zum Feigenblatt.
KI-Markierungen lösen insbesondere nicht das Problem, das Hochschulen eigentlich interessiert: Sie können nicht auf Basis des fertigen Elaborats feststellen, zu welchem Anteil der Mensch mit seinen kognitiven Fähigkeiten den Text erstellt und das behandelte Thema bis zur gewünschten Tiefe durchdrungen und verstanden hat.
Das galt zwar auch bereits vor der weit verbreiteten Nutzung von KI, hat sich seitdem aber weiter verschärft. Wenn dies aber das Problem nicht löst, dann ist zu fragen/stellt sich die Frage, was aus einer solchen Praxis an Konsequenzen erwächst und wie andere Lösungen aussehen könnten.
Uns erscheint problematisch, dass (unsichtbare) KI-Kennzeichnungen die ohnehin vorherrschende Misstrauenskultur in der KI-Ära verschärfen könnten. Damit werden sowohl Prüfer:innen, aber auch Studierende weiter verunsichert und in der Vermittlung, dem Erwerb und dem Prüfen dieses Erwerbs behindert. Es bleibt festzuhalten, dass ein Wasserzeichen weder ein zuverlässiges noch rechtlich belastbares Beweismittel darstellt, um Studierende wegen ihres KI-Einsatzes zu sanktionieren, der, so unsere Vorannahme, auch nicht mehr zeitgemäß scheint.
Denn das Schreiben mit generativer KI wird nicht in nächster Zeit verschwinden, sondern zunehmend als gängige Praxis normalisieren. Deshalb brauchen wir nicht immer ausgefeiltere technische Methoden, den KI-Einsatz in fertigen Texten aufzuspüren. Wir brauchen bessere Konzepte, klare Methoden und ein vertrauensvolles, gemeinsames Erarbeiten, um menschliche Kompetenz in der Ko-Aktivität mit KI-Systemen zu fördern (Buck und Limburg 2024), damit idealerweise auch neue Potenziale im Lehr- und Lernprozess wie auch in der Forschung erschlossen werden können.
Inzwischen liegen dazu verschiedene Vorschläge vor. Das 3P-Modell von Weßels (Weßels 2025) beispielsweise verbindet drei Ebenen und eignet sich vor allem für stärker empirisch ausgerichtete Wissenschaften:
- Produkt: Welche Qualität zeigt das Endergebnis in Form des schriftlichen Textes?
- Prozess: Wie ist das Forschungs-, Methoden- und Tooldesign zu bewerten? (Wie wurde der Prozess dokumentiert – und ggf. begleitet?) Welche Entscheidungen wurden getroffen, welche Quellen und KI-Systeme wurden verwendet und wie wurden diese überprüft? Dazu gehören auch Übungsräume, die den Erwerb von wissenschaftlicher Schreibkompetenz fördern: Diese beinhaltet auch fachsprachliche und stilistische Kompetenz, die über die Produktionsfähigkeit von statistisch nachweisbaren Textmustern hinausgeht.
- Präsentation: Kann die Person ihre Argumentation fundiert erklären, verteidigen, verändern und auf neue Fragestellungen übertragen?
Ein fachliches Prüfungsgespräch kann mehr über das Verständnis und die Eigenleistung aussagen als ein KI-Detektor. Es ist gerade für größere Studierendengruppen aufwändig zu realisieren, schult aber noch weitere Kompetenzen der Lernenden. Gleichzeitig werden transparente Regeln zur erlaubten KI-Nutzung und eine stärkere Prüfung von Validierungskompetenz benötigt. Dazu gehört: Fehler und Verzerrungen erkennen, Quellen bewerten, Behauptungen verifizieren und begründet entscheiden, welche KI-Vorschläge übernommen, verworfen oder weiterentwickelt werden.
Unsere Überlegungen lassen sich in drei zentralen Hinweisen zusammenfassen:
- Eine erkannte KI-Markierung beweist nur, dass in einem bestimmten Schritt des Schreibprozesses ein KI-Einsatz erfolgt ist. Wie dieser Einsatz aussah, in welchem Umfang und für welche Teilprozesse, ist damit nicht geklärt.
- Umgekehrt beweist das Fehlen einer Markierung nicht die exklusive menschliche Autorschaft, d. h. einen Schreibprozess ohne jegliche KI-Unterstützung.
- Anstelle einer bislang unzureichenden technischen Lösung brauchen wir didaktische Konzepte für eine zeitgemäße Lehre in Verbindung mit angepassten Prüfungsformaten.
Beim Einsatz von KI im Rahmen wissenschaftlicher Schreibpraktiken stellen sich fundamentale Herausforderungen im Umgang mit traditionellen Grundwerten von Zuverlässigkeit, Ehrlichkeit, Respekt und Rechenschaftspflicht (Wilder et al. 2022). Eine technische Antwort, die mehr Unsicherheit und Ungewissheit als Verlässlichkeit mit sich bringt, wird dem disruptiven Charakter des Schreibens mit KI nicht gerecht und verdeckt vielmehr die dahinterliegenden drängende(re)n Fragen. Die geforderte Transparenz jedenfalls benötigt andere Wege, die nicht ausschließlich auf technisch-rechtlichem Weg zu entwickeln sind.
Transparenzhinweis zur Entstehung
Für die redaktionelle Zusammenführung mehrerer Entwurfsfassungen, die sprachliche Überarbeitung und die ergänzende Quellenrecherche wurde generative KI in Form von ChatGPT, Claude und Perplexity eingesetzt. Die fachliche Prüfung und die Verantwortung für die veröffentlichte Fassung liegen bei den Autor:innen.
Literaturverzeichnis
Anthropic (Hrsg.). (2026a). Announcements: How Claude’s text watermark works. https://www.anthropic.com/news/claude-text-watermark. Zugegriffen: 19. August 2026.
Anthropic (Hrsg.). (2026b). How Claude marks AI-generated content. https://support.claude.com/en/articles/16266773-how-claude-marks-ai-generated-content. Zugegriffen: 13. August 2026.
Buck, I. & Limburg, A. (2024). Wissenschaftssozialisation in Zeiten künstlicher Intelligenz: KI-Tools im akademischen Schreibprozess. Hochschulmanagement 19 (1), 12–18.
Dathathri, S., See, A., Ghaisas, S., Huang, P.-S., McAdam, R., Welbl, J., Bachani, V., Kaskasoli, A., Stanforth, R., Matejovicova, T., Hayes, J., Vyas, N., Merey, M. A., Brown-Cohen, J., Bunel, R., Balle, B., Cemgil, T., Ahmed, Z., Stacpoole, K., Shumailov, I., Baetu, C., Gowal, S., Hassabis, D. & Kohli, P. (2024). Scalable watermarking for identifying large language model outputs. Nature 634 (8035), 818–823. doi:10.1038/s41586-024-08025-4
Europäische Kommission (Hrsg.). (2026). Verhaltenskodex für die Transparenz von KI-generierten Inhalten. https://digital-strategy.ec.europa.eu/de/faqs/transparency-obligations-under-article-50-ai-act. Zugegriffen: 16. August 2026.
Europäische Union. (2024). Verordnung (EU) 2024/1689 des Europäischen Parlaments und des Rates vom 13. Juni 2024. https://eur-lex.europa.eu/eli/reg/2024/1689/oj/deu?locale=de.
European Commission. (2026). Code of Practice on Transparency of AI-generated Content. https://digital-strategy.ec.europa.eu/en/policies/code-practice-ai-generated-content.
Google DeepMind (Hrsg.). (2024, 14. Mai). Watermarking AI-generated text and video with SynthID. https://deepmind.google/blog/watermarking-ai-generated-text-and-video-with-synthid/. Zugegriffen: 18. August 2026.
Kirchenbauer, J., Geiping, J., Wen, Y., Katz, J., Miers, I. & Goldstein, T. (2023). A Watermark for Large Language Models. In A. Krause, E. Brunskill, K. Cho, B. Engelhardt, S. Sabato & J. Scarlett (Hrsg.), Proceedings of the 40thInternational Conference on Machine Learning (Proceedings of Machine Learning Research, Bd. 202, S. 17061–17084). PMLR. https://proceedings.mlr.press/v202/kirchenbauer23a.html.
OpenAI (Hrsg.). (2024). Understanding the source of what we see and hear online. https://openai.com/index/understanding-the-source-of-what-we-see-and-hear-online/. Zugegriffen: 13. August 2026.
Weßels, D. (2025). Das wissenschaftliche Schreiben als Bildungsziel an Hochschulen: Ein Opfer von ChatGPT und Co.? Tagungsband AKWI 2025 (Gesellschaft für Informatik e.V. (GI), Hrsg.), Bonn. https://dl.gi.de/server/api/core/bitstreams/3c7be1e3-9bbb-44f8-8791-4c8e2e16008d/content. Zugegriffen: 13. August 2026.
Wilder, N., Weßels, D., Gröpler, J., Klein, A. & Mundorf, M. (2022). Forschungsintegrität und Künstliche Intelligenz mit Fokus auf den wissenschaftlichen Schreibprozess: Traditionelle Werte auf dem Prüfstand für eine neue Ära. in Katharina Miller, Milena Valeva & Julia Prieß-Buchheit (Hrsg.), Verlässliche Wissenschaft: Bedingungen, Analysen, Reflexionen, 203–223.